LangExtract es una biblioteca de Python de código abierto, desarrollada por Google Research, diseñada para transformar texto no estructurado en datos estructurados (JSON) utilizando modelos de lenguaje de gran tamaño (LLMs), como la familia Gemini o modelos locales a través de Ollama.
A diferencia de otras herramientas de extracción, su enfoque principal es la trazabilidad y el vínculo directo con la fuente. A continuación, se analizan sus principales casos de uso y las ventajas que aporta en distintos sectores:
1. Sector Médico y Salud (Health AI)
Este es uno de los campos donde la biblioteca ha demostrado mayor utilidad debido a la complejidad de los documentos.
- Extracción de notas clínicas: Procesar informes médicos escritos a mano o dictados para extraer diagnósticos, síntomas y antecedentes familiares.
- Gestión de medicación: Identificar nombres de fármacos, dosis, frecuencias y vías de administración dentro de historiales clínicos extensos.
- Investigación clínica: Estructurar datos de pacientes a partir de literatura médica o reportes de ensayos para su análisis estadístico posterior.
2. Sector Legal e Inmobiliario
La capacidad de mapear cada dato extraído a su posición exacta en el texto original es crítica en este ámbito.
- Análisis de contratos: Extraer fechas de vencimiento, partes involucradas, penalizaciones y cláusulas de rescisión.
- Auditoría de pólizas de seguros: Identificar exclusiones específicas, límites de cobertura y condiciones especiales, permitiendo a los suscriptores verificar rápidamente la fuente de la información.
- Cumplimiento normativo (Compliance): Detectar si ciertos términos legales obligatorios están presentes en grandes volúmenes de documentos corporativos.
3. Finanzas y Análisis de Negocio
- Informes trimestrales: Extraer métricas financieras clave (EBITDA, ingresos por región, proyecciones) de PDFs extensos y desordenados.
- Procesamiento de facturas y recibos: Convertir documentos de proveedores con diferentes formatos en entradas de base de datos uniformes.
- Inteligencia de mercado: Analizar noticias o transcripciones de llamadas de resultados para identificar tendencias de competidores o menciones de productos.
4. Optimización de Sistemas RAG (Retrieval-Augmented Generation)
LangExtract se integra frecuentemente en flujos de trabajo de IA para mejorar la calidad de las respuestas.
- Etiquetado semántico: Antes de indexar documentos en una base de datos vectorial, se usa LangExtract para crear metadatos estructurados que faciliten una recuperación más precisa.
- Verificación de hechos (Fact-checking): Al proporcionar los "offsets" (posiciones de caracteres) exactos de donde provienen los datos, permite que los sistemas de IA muestren al usuario final la evidencia visual del documento fuente, reduciendo el impacto de las alucinaciones.
5. Análisis de Literatura y Humanidades Digitales
- Extracción de entidades y relaciones: Como se muestra en los ejemplos de la propia biblioteca (usando Romeo y Julieta), permite identificar personajes, sus emociones y la evolución de sus relaciones a lo largo de una obra literaria, manteniendo siempre la referencia al verso original.
Características técnicas destacadas:
- Trazabilidad Extrema: Cada dato extraído incluye las coordenadas exactas del texto original, lo que permite generar visualizaciones HTML interactivas donde el usuario puede pasar el ratón sobre un dato y ver resaltada la fuente.
- Procesamiento en Paralelo y Fragmentación Inteligente: Está optimizada para documentos muy largos; divide el texto en fragmentos (chunks) respetando la coherencia semántica y los procesa de forma simultánea para ahorrar tiempo.
- Estrategia Multi-pasada (Multi-pass): Puede realizar varias pasadas sobre el mismo texto para asegurar que no se omitan detalles sutiles en la primera lectura.
- Aprendizaje por ejemplos (Few-shot): No requiere reentrenar modelos; basta con darle unos pocos ejemplos de "texto -> extracción deseada" para que aprenda el esquema que necesitas.
En resumen, LangExtract es ideal para cualquier escenario donde la precisión y la capacidad de auditoría sean más importantes que la simple velocidad de procesamiento, convirtiéndose en un puente confiable entre el caos del texto libre y la rigidez de las bases de datos.
Cómo extraer datos de texto con IA paso a paso
El trabajo con LangExtract sigue una lógica ordenada. No es magia: se define qué se quiere sacar, se enseña con ejemplos y se revisa la evidencia que devuelve el modelo. El proceso típico tiene cinco pasos.
- Definir el esquema de salida. Antes de tocar el texto hay que decidir qué campos se necesitan y con qué tipo de dato. Un esquema claro evita extracciones ambiguas y reduce el trabajo de limpieza posterior.
- Aportar unos pocos ejemplos (few-shot). Basta con mostrar al modelo dos o tres casos de «texto de entrada y extracción deseada». No se reentrena nada: el modelo aprende el patrón del ejemplo.
- Trocear el documento. La biblioteca divide el texto en fragmentos que respetan la coherencia semántica. Así se pueden tratar informes largos sin perder el hilo de cada sección.
- Procesar en paralelo. Los fragmentos se lanzan de forma simultánea, lo que reduce de forma notable el tiempo total frente a un recorrido secuencial.
- Revisar la evidencia. Cada dato vuelve con su posición exacta en el texto original, de modo que la persona que revisa puede ir directa a la fuente y validar en segundos.
Ese último punto es el que separa una extracción útil de una caja negra. Si el resultado no se puede auditar, no sirve para procesos donde un error tiene consecuencias reales.
Por qué la trazabilidad cambia las reglas al extraer datos de texto con IA
La mayoría de herramientas de extracción devuelven un JSON limpio y poco más. El problema aparece cuando alguien pregunta de dónde ha salido ese dato. LangExtract responde a esa pregunta por diseño: cada valor extraído viaja con las coordenadas exactas del texto que lo originó.
Esto tiene tres consecuencias prácticas. La primera es la verificación: se puede comprobar el dato contra su fuente sin releer el documento entero. La segunda es la confianza: los sistemas que muestran la evidencia visual reducen el peso de las alucinaciones, porque el usuario ve el fragmento real del que se ha sacado la información. La tercera es la auditoría: en entornos regulados, poder reconstruir el origen de cada campo es tan importante como el campo en sí.
También encaja bien en sistemas RAG. Antes de indexar documentos en una base vectorial, conviene crear metadatos estructurados. LangExtract hace ese etiquetado semántico, y después la recuperación de información es más precisa porque el buscador no solo tiene el texto, sino también los campos que lo describen.
Extraer datos de texto con IA en gestoría y agencias de colocación
En un despacho o en una agencia que trabaja con documentación laboral, el cuello de botella casi nunca es la falta de datos, sino su formato. Contratos en PDF, nóminas, altas, comunicaciones y correos llegan en modelos distintos y con campos que no siempre coinciden. Ahí es donde una extracción con trazabilidad aporta valor inmediato.
Pensemos en una agencia de colocación que gestiona altas de empleadas de hogar. Cada expediente trae fechas, jornadas, datos de la persona empleadora y condiciones que hay que volcar en el sistema. Extraer esos campos de forma automática y con la referencia al documento original ahorra horas de tecleo y, sobre todo, reduce errores de transcripción. El mismo patrón sirve para clasificar documentación de entrada o para comprobar que un contrato contiene las cláusulas exigidas.
Quien ya trabaja con un software para agencias de colocación sabe que el orden en los datos es lo que permite escalar. La extracción automática encaja como una pieza más del circuito: alimenta la base de datos con información limpia y verificable. Para el día a día de la gestoría laboral de empleadas de hogar, esa limpieza previa marca la diferencia entre un expediente revisado en minutos y una tarde de comprobaciones manuales.
La clave no es sustituir a la persona que revisa, sino darle mejores materiales. El modelo propone el dato y señala de dónde lo ha sacado; la persona decide si es correcto. Con ese reparto de tareas, la tecnología se vuelve fiable y el trabajo, más rápido.
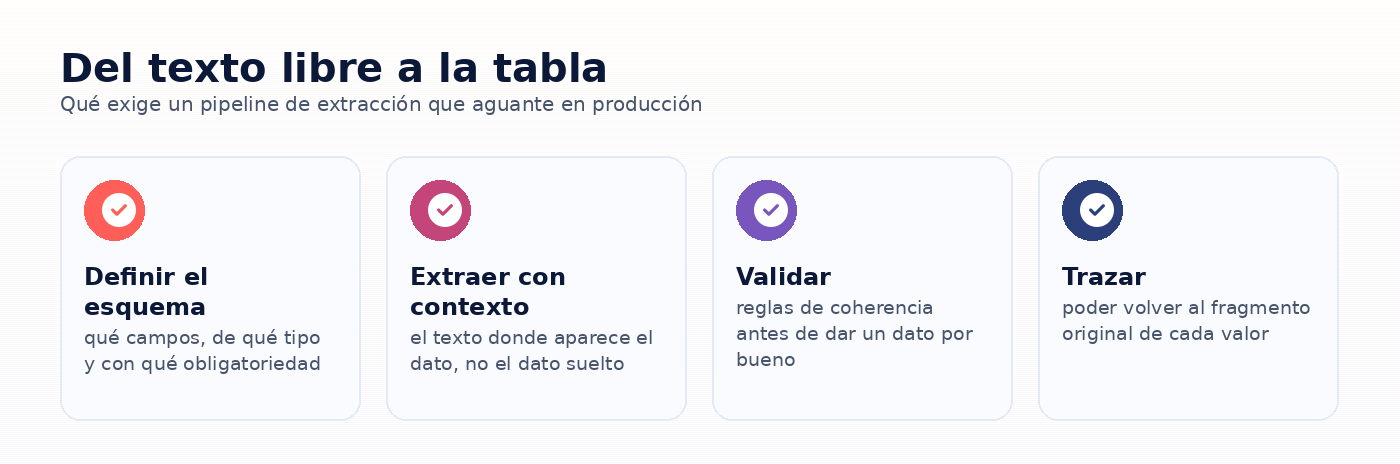
Qué exige un pipeline de extracción que aguante en producción
Preguntas frecuentes
¿Hace falta entrenar un modelo propio para extraer datos de texto con IA?
No. LangExtract funciona con aprendizaje por ejemplos: se le dan unos pocos casos de entrada y salida deseada y aprende el esquema sin reentrenar. Se apoya en modelos de lenguaje ya existentes, como la familia Gemini o modelos locales a través de Ollama.
¿Qué diferencia hay frente a una extracción convencional?
La diferencia principal es la trazabilidad. Cada dato extraído conserva las coordenadas exactas del texto original, lo que permite verificar la fuente y generar visualizaciones donde se resalta de dónde sale cada valor.
¿Sirve para documentos muy largos?
Sí. La biblioteca divide el texto en fragmentos que respetan la coherencia semántica y los procesa en paralelo. También admite varias pasadas sobre el mismo texto para no dejar detalles sutiles sin capturar en la primera lectura.
¿Se puede usar sin conexión a un servicio en la nube?
Sí, siempre que se trabaje con modelos locales a través de Ollama. Eso permite tratar información sensible sin sacarla de la infraestructura propia, algo relevante en datos médicos o legales.
En resumen
- LangExtract es una biblioteca de Python de código abierto de Google Research para extraer datos de texto con IA y devolverlos en JSON.
- Su seña de identidad es la trazabilidad: cada dato lleva las coordenadas exactas del texto original.
- Trabaja con pocos ejemplos (few-shot), sin reentrenar modelos, y admite modelos en la nube o locales con Ollama.
- Está pensada para documentos largos: fragmentación semántica, procesamiento en paralelo y estrategia multi-pasada.
- Encaja bien en salud, legal, finanzas, sistemas RAG y en la gestoría diaria, donde la auditoría del dato pesa tanto como el dato.
Si trabajas en el ámbito de la gestión del hogar, este mismo enfoque de datos ordenados es el que usamos en el sistema para agencias de colocación y con el Agente Tribbe. ¿Quieres verlo aplicado a tu caso? Hablemos.